
最近把折腾了一阵子的两个东西都开源了,一条线上的:一个本地跑的语音转写命令行工具,一个长在它上面的 agent 技能(把音视频直接变成一篇能进笔记库的文章)。
为什么不用现成的
- 云 ASR 按分钟计费。一场 2 小时的会议、一周十几个播客,成本很快就不对劲,而且音频要上传到别人服务器。
- whisper.cpp 手搓太烦。编译参数、模型格式、VAD 分块、长音频拼接、中文断句……每换一台机器重来一遍。
- YouTube/B 站 有现成字幕,但只有一部分视频有,而且字幕没标点、断句乱,二次加工成本高。
所以做了两件事:一个把模型管理干净的 CLI,和一个把转写结果整理成笔记的技能。
一、handy-transcribe:Rust 写 CLI ,模型随取随用
它复用了开源桌面应用 Handy 的批处理流水线(解码 → VAD 分块 → transcribe.cpp 推理 → 拼接 → 后处理),去掉录音/UI/剪贴板,只留一个无头 CLI 。
- 完全本地:macOS 走 Metal ,其他平台 CPU 。不上传,不需要账号,不按分钟付费。
- 模型目录内置 76 个、21 个家族:Whisper 、Parakeet 、Canary 、SenseVoice 、Qwen3-ASR 、Voxtral 、Moonshine 、GigaAM…
--list-models一次看全,✓标记已缓存。 - 输入随便:本地 mp3/wav/flac/ogg/m4a/aiff ,或 MP4 家族视频容器的音轨;也接受直接的 http(s) 媒体 URL 。
- 输出干净:正文走 stdout (可以直接管道),进度和耗时走 stderr 。
--json给出 backend 、设备、RTF 、识别语言。
cargo install handy-transcribe        # 或 cargo binstall handy-transcribe
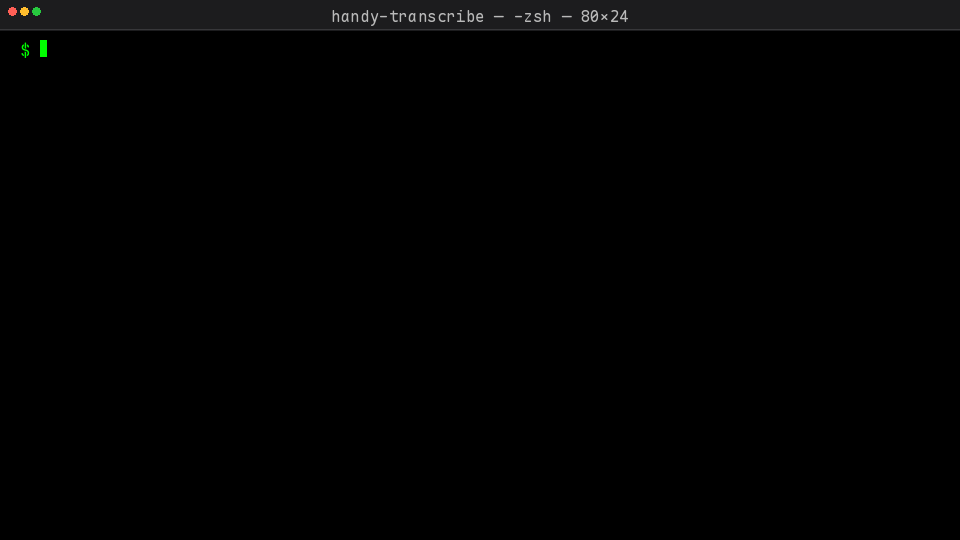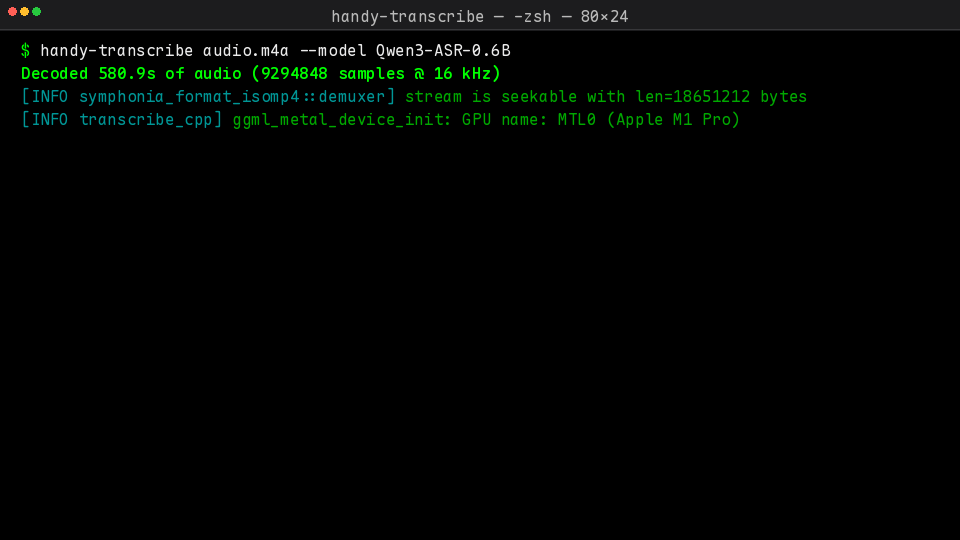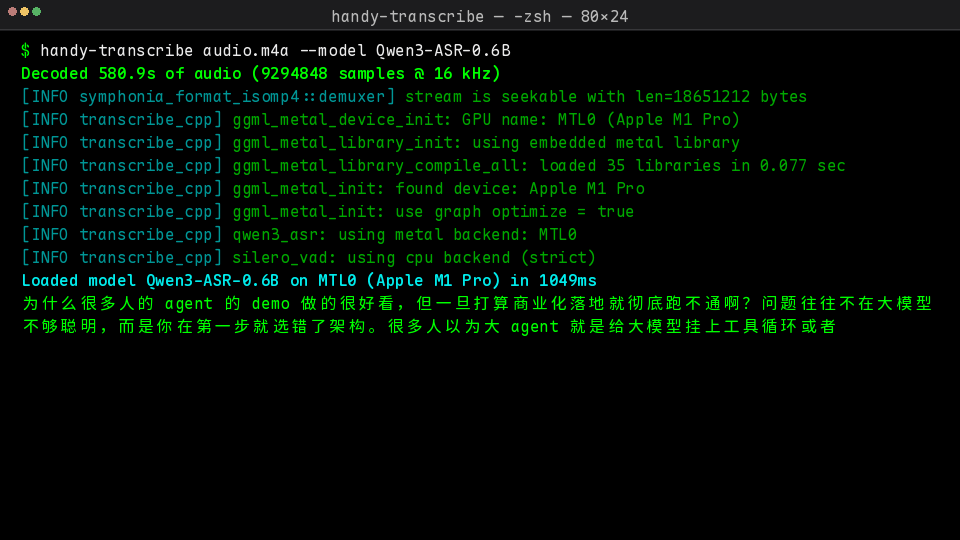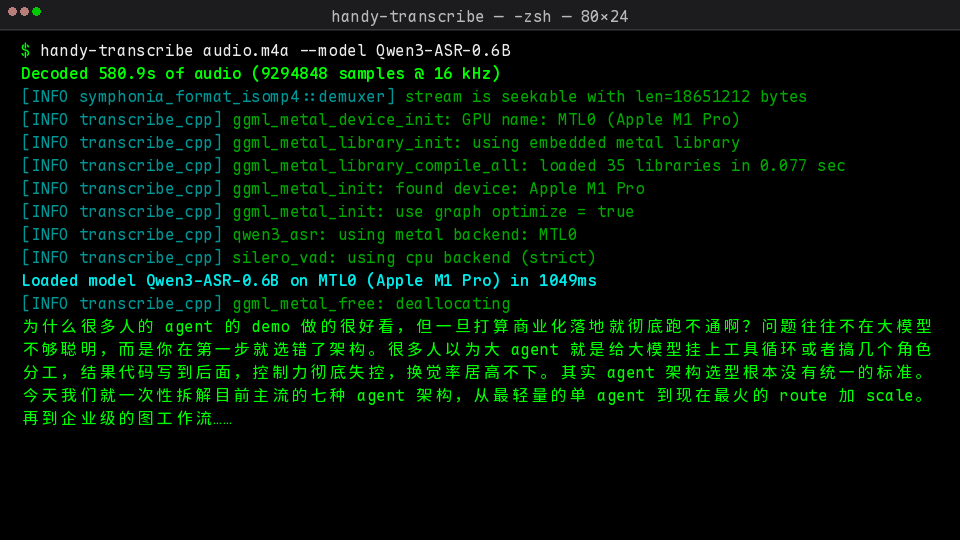
handy-transcribe ./meeting.m4a
handy-transcribe ./talk.wav -m Qwen3-ASR-1.7B -l zh
handy-transcribe ./podcast.mp3 --json
YouTube 之类的网页先用 yt-dlp 抽音轨再喂进来——这是故意的,提取器交给专业项目维护,CLI 只管转写。
实测:16 分钟( 972 秒)中文技术演讲,49 秒转完。机器是 M1 Pro ,模型 Qwen3-ASR-0.6B Q8_0 ,约 20 倍实时。文本准确到只需要改几个同音字。
二、pi-media-transcribe:转写完,自动变成一篇笔记
光有文本其实没什么用,还得有人分段、写摘要、挑目录、打标签。所以给 Pi(一个开源 coding agent ,可以装技能包)写了个技能,三种模式:
- 只转写:出文本(带缓存,重复跑是秒回)。
--raw逐字落笔记:不需要任何 API key ,全程离线,零成本。- 默认模式:LLM 校对错字 → 按主题分
###小节 → 写 150~300 字摘要 → 在你的笔记库里挑目录 → 打 1~3 个主题标签 → 写成带 frontmatter 的 Markdown 。
pi install npm:pi-media-transcribe
# 然后直接对 agent 说:把这个视频转录一下存到我的笔记里:<链接>
产物大概长这样:
---
created_at: 2026/10/31 22:14
tags:
  - youtube
  - 自动转录
  - RAG
  - 知识图谱
---
来源: https://www.youtube.com/watch?v=...

## 核心内容
<150~300 字摘要>

## 正文
### 传统向量检索的底层天花板
<校对并分段后的正文>
那次 16 分钟的视频,出来是一篇 18.8 KB 的笔记:一段摘要 + 17 个小节。落点在 资料/02-人工智能/AI 智能体/ —— 目录是它自己在现有目录树里挑的。
几个自己比较在意的细节:
- 标题语言跟着内容走(中/英/日/韩/俄/德/西/法/葡九种),不是硬编码中文。
- 长音频不会爆上下文:超过阈值自动分块压缩再合并,三小时的播客也能过。
- LLM 失败不丢工作:直接落一份原始转写的笔记,重跑只重试润色那一步。
- 同名笔记不覆盖(自动加序号),路径校验在笔记库之内。
踩过的坑,顺便记一下
- 首次运行会静默下载 850 MB 的默认模型。后来在 SKILL 里加了硬规则:先告诉用户用哪个模型、多大、要不要换。
- 国内拉 HuggingFace 模型经常卡死,支持
HF_ENDPOINT(中文文档里给了镜像示例)。 - LLM 只看得到我给的目录列表,否则它会把笔记往任意路径写;路径还得再校验一次。
- 缓存键一开始用了
stat -f,在 Linux 上语义完全不同( GNU 的-f是查文件系统),换成了「版本号 + 文件大小」。
已知限制(先说清楚)
- Windows 没测过。CLI 依赖 CMake + C++ 工具链,macOS/Linux 的 CI 都绿了,Windows 欢迎有人帮忙试。
- 拉丁语系语言的标题回退英文(德/法/西/葡)。正文语言是对的,只是小节标题是英文;可以用
--language/配置指定。 - 润色模式花 token。只要文本不要笔记的话用
--raw,一分钱不花。 - 模型是第三方的,许可证各不相同( Apache-2.0 / MIT / CC-BY-4.0 / 非商用),商用前看一眼。
想听听用的人怎么说
- 你主要拿它处理什么?会议、课程、播客、还是二次剪辑素材?
- 还需要哪些模型或语言的优先支持?
- 有 Windows 用户愿意帮忙跑一次 CI 之外的真实测试吗?
两个仓库都是 MIT:
- CLI: https://github.com/cyub/handy-transcribe (
cargo install handy-transcribe) - 技能: https://github.com/cyub/pi-media-transcribe (
pi install npm:pi-media-transcribe)
 Select Language