
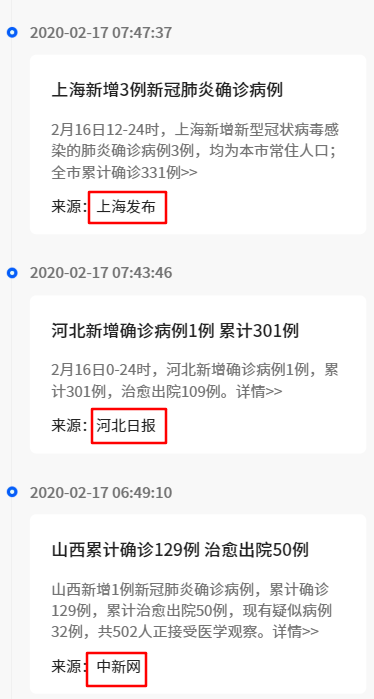
如果不是,通常是用啥方法来做?
如果不是,通常是用啥方法来做?
 |
1
这个大概率是坐了一个小编
|
 |
shanlanFeb 17, 2020
2
1.官方 API
2.人肉抓取 3.定制爬虫 |
 |
murmurFeb 17, 2020
4
官方的新闻直接爬,非官方的人工洗稿
|
 |
twor2Feb 17, 2020
5
应该是人工的吧,至少半人工
|
 |
litmxsFeb 17, 2020 via Android
8
就算是人力成本也不是很高吧
|
 |
metamaskFeb 17, 2020
12
不是一套,
一般是先自己搭个框架, 像这种,可以分别写 爬取机制 + 清洗机制(parse ),然后做入库。 像 v 站一个老哥的,pyspider 用来做这玩意就还不错。 |
 |
locozFeb 17, 2020 via Android
13
新闻类的直接上智能提取就行了,不用写规则,而且这种需求就无脑刷最新新闻那一页就行。
至于最终发布…显然部分非官方的新闻是人肉处理的,有新闻就直接推到编辑那,审核没问题了再提出关键内容放上去。 |
 |
nocoolsandwichFeb 17, 2020
14
看你样子是想要疫情的数据吧,github 有人整理好了,数据来源丁香园好像是.https://github.com/BlankerL/DXY-COVID-19-Data
|
 |
delectateFeb 17, 2020
15
来源就那几个,写规则就好;一般人机器爬,人肉审、二审、发。
|
 |
alaikisFeb 17, 2020
16
做几个规则,一个源配置一下就好呀,没那复杂
|
 |
EricccccccccFeb 17, 2020
19
人力成本很低啊
|
|
20
|
 |
MaviousFeb 17, 2020
21
灰字提要,得人工来提取吧,毕竟新闻也没有固定格式,核心内容还是要人来提取的。
|
 |
jingniaoFeb 17, 2020 via Android
22
丁香园是人工的,因为早上七点之前好像大都不更新。
刚开始那几天好像是小编通宵 /轮班了,晚上也有更新。 |
 |
jabin88Feb 17, 2020
23
正文提取 算法,不要用正则
|
 |
2MEFeb 17, 2020 via Android
24
关键词 Readability 识别新闻站的正文进行提取
|
 |
herozzmFeb 17, 2020 via Android
25
通用爬虫 针每个新闻源定制规则
|
 |
wolfanFeb 17, 2020 via Android
26
爬微博不就成了😅
|
 |
lsheroFeb 17, 2020
27
有个岗位叫做 值班编辑
|
 |
chromingFeb 17, 2020
28
专业一点的是用火车头这类工具每个网站写提取规则来爬。要求不高的话找现成正文提取算法直接提取
|
|
chromingFeb 17, 2020
29
如果只是几个网站的话那人工直接复制更简单
 |
 |
ChangQinFeb 17, 2020
31
我想爬 twitter 的数据,结果开发者账号好难申请啊。。。
|
 |
yinzhiliFeb 18, 2020
32
这种肯定是人工介入的,怕出问题责任重大
|
 |
enrollsFeb 22, 2020
33
认真观察网页结构,其实是有通用方法的,印象笔记不是也剪藏了莫。
(顺带测试回复功能) |
 3


 Select Language